登录
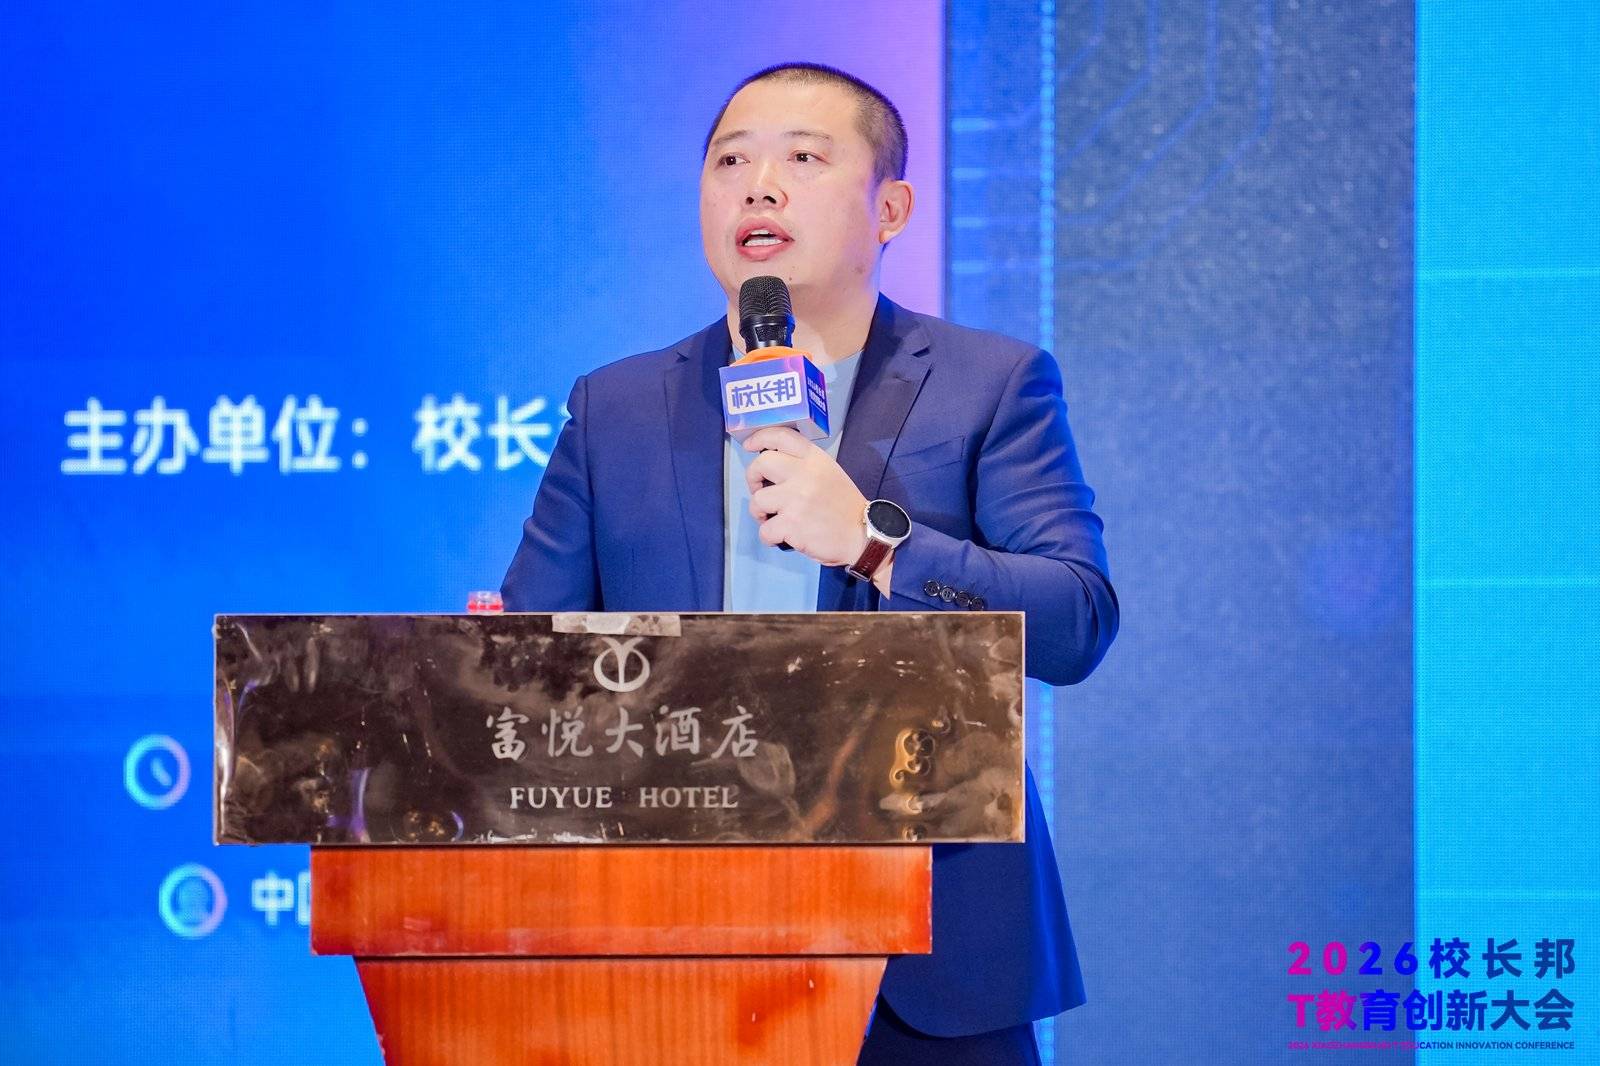
“我先从一个虚一点的开始。”
王海真开场没有放产品图,而是讲起了生产力。人类社会的发展,本质是生产力的进步;每一次产业革命都带来财富的更迭;现在的第四次革命,是人工智能。“谁掌握了人工智能,谁就掌握了下一个时代的生产力。”
他用一句话定义AI:用硅基生命——半导体——产生碳基智慧。“以前所有的生产力变化都在体力上,人工智能不一样,它在智力上。以前你复制不出一个人,现在可以用硬件产生人类的智慧。”
他是松鼠AI智能老师教研院总裁。在2026校长邦T教育创新大会上,他带来的题目是《AI大模型如何重塑学习未来》。整场分享,他几乎不讲商业模式,只反复讲三件事:数据、算法、以及它们如何落到每一个孩子身上。
以下为演讲实录,经编辑整理:
01 2500年前的那个难题,卡点一直是“没有人”
“孔子在2500年前就讲因材施教,最大的卡点是什么?是没有老师。”王海真说,你不可能让一个数学老师一对一教一个孩子数学、一个语文老师一对一教一个孩子语文——只有一对一才能解决因材施教,但你没有那么多老师。
“现在,这件事变成可能了。”通过端侧设备产生的智慧来辅导孩子,硅基生命产生的“碳基智慧”让一对一第一次有了规模化的可能。
他介绍,松鼠AI用了12年,研发经费约16亿,但做的是垂类小模型,和 DeepSeek、Open AI的大模型不是一个逻辑。“大模型我们比不了,但在垂类的教育模型里,我们的算法团队绝对是全球第一。”
他反复强调一个判断:数据是AI的粮食。“现在有人讨论人工智能是不是到了上限,原因很简单——人类到现在存储的数据几乎用光了。有人预言token会越来越便宜,为什么?因为做大模型厂商需要新数据,只有降低token成本,才能让更多人用,才会产生新数据,形成闭环。”
02 5000万学生、200亿行为、860万条错因
数据从哪来?他给了一串数字。
2026年7月16日,他和公司CTO 两个人到人教社本部汇报;7月28日发函,合作承建中国基础教育数据集。这个项目由国家发改委立项,人教社是执行方。“约了中国各个做教育数据的企业全部去汇报,为什么选我们?因为我们的数据质量非常高。”
以中考为例,他们分析了1600套卷子,标注考评、难度、重要程度等多个维度。数据在上海市徐汇区做了公证:4300万学生数据,公证时还比较靠前,现在累计约5000万;100多万老师、700多万次作业布置;5亿题库。
“为什么大家喜欢找有经验的老师、有经验的医生?因为他积累的数据多。一个老师教2000个、3000个孩子了不起了,但能教5000万孩子吗?不可能。”
他还展示了行为数据:200亿条,包括孩子的情绪、老师给的标签、看报告的行为、快进拖拽跳过等动作,甚至用多模态摄像头抓取表情分析情绪,实时生成内容跟学生沟通。
真正让他得意的是两样东西。
一是知识图谱。他解释,学会一个八九年级的知识点,前面可能藏着很多前置问题,“有的知识点有300多个前置,有的只有23个”。教育部发布的基础教育知识图谱建设,成员单位包括清华、人教社、北师大、松鼠、智谱、联想——“其中唯一做教育和科技教育的企业就是我们,标准就是我们制定的。”
二是错因。“一个学生用手写笔写电子草稿,即使写错也要写过程,因为我们要评价过程。”端侧小模型加云端大模型,能识别出孩子把正方形的周长当成了面积。“一道题里可能有1万个、2万个不同的错因,不同孩子产生的错因我们全部记录,现在已经积累了860万条。到了一定程度,答案一出来,我就知道你大概因为什么错了。”
03 同一个知识点,有人做13道题,有人做2道
“给内容之前,最重要的是对学生做出正确的评价。评价偏了,给的内容就全偏了。”他把知识点拆到最细颗粒度叫L1,L1组合成L2、L3。系统要做的第一件事,是把孩子脑子里的知识结构映射到整个体系上:哪些掌握了、哪些没掌握、哪些快忘了、哪些学了三遍才学会。然后实时判“此时此刻,这个学生学哪个知识点性价比最高”。
推荐内容遵循“最近发展区”:只推学习区,不推舒适区和恐慌区。“一个50人的教室,老师按70分讲,60分的听不懂,90分的听着没意义,60分以下和80分以上的全部在浪费时间。”
同一个知识点,不同孩子的掌握速度差得惊人。“这个孩子要做13道题才学会,那个学霸2道题就结束。”题目数量自适应。题目难度也在实时变化:一个学生32难度的题做错了,用时23秒而建议是25秒——“说明32太难,降到17”;17做对了,“状态变了,升到38”;38做对,升到59,再升到84。“每个孩子升降的斜率都不一样。”
从哪开始测?“从关联性最强的知识点开始测,因为它能带来大量数据。”但学苗大概率关联性强的也有问题,就从前面的简单知识点测起;学霸大概率后面才有问题,从更后面、更难的测起。
他特别提到一个“反常识”的细节:艾宾浩斯遗忘曲线直接用来推送,准确率不到15%;他们依据两个变量——每个学生的遗忘速度不同、不同知识点的遗忘速度不同——两条线耦合,准确率约85%。
04 11万人、两小时:一场吉尼斯挑战给出的答案
2024年9月21日到22日,松鼠AI做了一场吉尼斯挑战:从一年级到高三,11万2718名学生在两小时内学完课程。
据他介绍,艾瑞咨询的评估系统设计了108435条不同的知识点路径、111704条个性化的习题路径,自适应水平达到96.2%。“只有100多个知识点,十几万人过来学,学苗到不能再苗的凑在一起,学霸到不能再强的也凑在一起,得到了这个结果。”
在交付端,他把价格讲得很直白:C端约200元一个月,“无非消耗点电和token”。北美课程小学已做完,正在开发初中和英语。他还展示了联合国教科文组织部长级会议发言的照片、与培生签署人工智能战略合作的照片。“我们也在准备港股上市。”
结语:赚的是时代给你的溢价
分享的最后,他回到了“时代”这个词。
“如果是1990年,我们应该去广州做个倒爷,倒点电视、倒点牛仔裤,那时候可以赚很多溢价,因为那个时代如此。2000年,我们应该去买房子,因为中国的财政全部锚在土地上。今天应该干什么?应该干跟人工智能相关的东西。”
“只要你做的和人工智能相关,你会拿到很多额外的溢价,而这个溢价是时代给你的。”
这句“时代溢价”,是整场技术剖白里最像一句开场白的话——他从生产力讲起,最终又落回了生产力。






教育界网
登录